



代码
未读
我花两个通宵,把 Soul App 的协议逆成了纯 Python
本文记录作者对 Soul(Android 6.37.0)网络协议的完整逆向经历,目标是将协议彻底复现为不依赖手机、不依赖 so 的纯 Python 客户端,连签名字段也要纯 Python 计算。作者声明全程仅使用自己的账号与授权的 root 设备(Pixel 6),仅供技术交流。
文章先盘点目标 App 的防护面:TLS 叠加私有 HTTPDNS 域(公网不解析)、主进程为 32 位(使 eCapture 等 eBPF 无注入方案出局)、反 Frida 双层检测、JNI 全部走 RegisterNatives 动态注册而没有 Java_* 导出、so 核心代码在磁盘上为密文、常量静态加密且 GOT 静止态也是密文、服务端强校验差一字节即拒。作者认为这类防护本质只是抬高时间成本,并非数学上不可解。
最终交付物是一个约 40 行的核心签名算法 cs_offline.py(标准库零依赖),以及一套完整客户端 soul_client/,覆盖短信登录、token 轮换、广场浏览/点赞/评论/关注/发帖(含图片)与 IM 收发,全部经服务端 10001 实测通过。颇具讽刺意味的是,算法本体最终被证明只是标准 MD5 加两个字符置换和两个明文常量。
入口定位上,作者从 System.loadLibrary 切入,命中 ImEncryptUtils 与 SoulPowerful 两个 JNI 门面,再逐层上溯调用链,梳理出 loadLibrary → 两个门面 → sy.h/sy.i(Retrofit 构建)→ sy.q(SoulNet 组装 OkHttp)→ ty.f(ParamsInterceptor,即 HTTP 签名落点)→ ColdStartupHelper.u 与 m0(DomainsManager)、g60.a(IM 连接配置)的结构。副产品包括按四套环境全量提取的 40 多条域名、IM 入口 im.soulapp.cn:8393 采用 HTTPDNS 多 IP 轮询,以及 ChatManager 到写线程再到 socket 的完整链路。
根据 ty.f 源码,作者整理出 HTTP 签名口径:签名串只取 url 的 path 而不带 host,将 query 与解码后的 form 合并排序,以 k=值(值用解码值)拼接;另一路取 tk、di、sdi、aid、av、at、User-Agent 七个头,按 Java 字符串排序后仅拼值;cs 交给 SoulPowerful.l 计算,sthor 走 SoulPowerful.i(v3,AB 开关),at 由另一个 so 里的 Hi.bth 生成。作者当时已意识到这些细节都可能成为服务端重算签名的雷区,随后发现自己选中的 ty.f 其实是旧版死代码,真正运行的拦截器位于 cn.soulapp.baseutility.fingerprint 相关类中。
文章规划的后继章节依次覆盖:App 阻止注入的现状、抓包的三个大坑、磁盘上并不存在的 so 代码带来的挫败、IM 帧解密的首次突破、cs 签名的五幕攻坚战、IM 消息签名与一次教科书级 dex 注入、服务端给予的教训、剩余口径的收尾,以及整体复盘。作者强调本文重在记录当时如何判断、为何这样选择、踩了什么坑与如何纠正,而非只罗列结论;正文在截断处结束,上述若干章节目前仅有标题。

从网盘链接到图文发布:一个内容自动化工具的技术实现记录
本文记录了一个网盘内容自动化工具的技术实现。该工具旨在解决网盘资源整理与内容发布高度依赖人工的痛点,实现了从网盘链接提交、资源识别转存、分享链接生成、AI文章撰写到多平台发布的全链路自动化,并扩展支持了多链接合集、公众号文章改写与监听等功能。
在技术架构上,项目采用FastAPI结合SQLAlchemy异步版与MySQL构建后端,前端使用Ant Design Pro,最终单体部署。系统采用清晰的分层架构:API层轻量路由,Service层负责业务编排,Repository层处理数据读写,同时抽象出Provider、Publisher和AI模块,以有效隔离不同网盘平台协议、发布渠道差异及AI接口调用。
针对网盘转存、AI生成等耗时操作,系统设计了基于Pipeline的后台任务机制。用户提交任务后立即返回任务ID,系统通过asyncio在后台异步执行实际处理流程,前端通过轮询获取任务状态、进度与日志,从而避免HTTP请求超时,保障良好的用户体验。

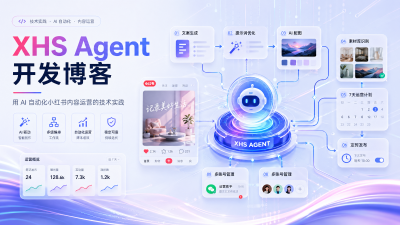
XHS Agent 开发博客:用 AI 自动化小红书内容运营的技术实践
XHS Agent 是一个面向小红书内容创作者的 AI 自动化运营工具。根据用户设定的运营目标,它能自动完成笔记文案生成、AI 配图(支持海报与真实照片两种风格)、参考图片素材管理、7 天发布计划制定,并通过 APScheduler 定时发布到账号,全程无需人工干预,同时支持 WxPusher 微信通知和多账号 Web 管理界面。
项目核心采用多级 AI 编排流水线:第一阶段由 text_service 调用 LLM 生成标题、正文、标签,并决策图片风格;第二阶段 prompt_agent 从预设模板中优化提示词;第三阶段 image_service 负责生成图片。海报模式特别使用串行生成策略,将第一张图作为风格锚点,确保多张图片色调、排版高度一致;真实照片模式则直接并发以保留多样性。
参考图片系统允许用户按风格、人物、产品、场景、品牌五类上传素材,由 GLM-4.6V 视觉模型自动标注,注入上下文以提升品牌贴合度。技术栈基于 FastAPI + aiosqlite 异步后端、React + Ant Design 前端、uv 包管理与 Docker 一键部署,精准解决人工运营中高频、高质、风格一致的痛点。

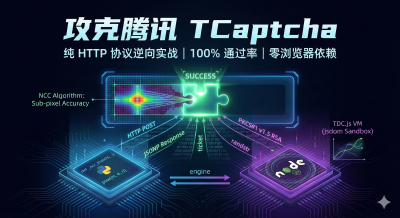
攻克腾讯 TCaptcha 滑块验证码:纯 HTTP 协议逆向实战
本文记录了一次对腾讯 TCaptcha 滑块验证码的完整逆向工程实践,以粉笔教育登录流程为研究对象,目标是通过纯 HTTP 协议实现全自动化破解,不依赖 Selenium 或 Playwright 等浏览器自动化工具,最终实现 100% 通过率。
核心挑战包括:完整还原 TCaptcha 三阶段协议、优化 NCC 模板匹配算法计算拼图块亚像素级位置、高效求解 PoW 工作量证明,以及执行高度混淆的 TDC.js 虚拟机并仿真真实用户轨迹。
文章首先通过 HAR 抓包分析业务风控流程:发送短信接口触发 430 状态码返回 contextId,前端弹出腾讯验证码 iframe,用户验证后获取 ticket 和 randstr,提交 captcha/check 接口解除风控。验证码系统与业务系统解耦,可独立破解后提交凭证。
随后还原了前端 RSA/ECB/PKCS#1 v1.5 加密逻辑(手机号+时间戳),并用纯 Python 实现兼容的加密函数。
整体方案涵盖协议分析、图像处理、算法优化、PoW 求解和 JS 虚拟机执行等多环节,构建出一套稳定、可工程化的纯 HTTP 自动化破解解决方案。

抖音数据分析MCP开发
Douyin MCP 是一个专为 AI 助手打造的本地化数据服务桥梁,通过 Model Context Protocol (MCP) 协议打破信息壁垒,赋予大模型直接检索和分析抖音海量数据的能力。该项目的核心突破在于摒弃了传统的高延迟外部签名服务器方案,巧妙利用 Python 嵌入式 V8 引擎(py-mini-racer)在本地进程内完全攻破了抖音最核心的 a_bogus 反爬虫防线,结合现代 Python 异步生态构建了一个高稳定、易部署的数据访问架构。


Cursor无限Max模型
本文介绍了一种通过修改Cursor客户端本地代码,将Claude 3.7模型的上下文窗口提升至200K的方法,从而实现类似Max版本的体验。具体做法包括:在`workbench.desktop.main.js`文件中修改`getEffectiveTokenLimit`函数,将返回值设为200000,实现所有模型或指定模型的上下文窗口扩展;修改`getModeThinkingLevel`函数,将思维深度设为最高;调整UI显示,使普通Claude 3.7模型在界面上显示为“MAX”并应用高亮样式。文章强调,这些更改仅影响本地客户端显示和行为,实际API调用和计费仍受Anthropic官方限制,无法绕过API密钥或服务器端的真实限制。最后提醒用户修改前做好备份,并注意这些更改不会改变Claude的底层功能。

AI
未读
教育版中国区域限制解除办法
关于教育版的中国地区的删除 可以通过修改前端方式来进行直接请求 首先是地区的校验打开自己检查一下自己的学校 在这里添加上,然后就能进行国内学校的检索 <option value="CN">China</option>
然后检索之后,确定你要申请的学校 然后回到https://www.cursor.

DeepSeek 开源 FlashMLA:高效 MLA 解码新时代
DeepSeek发布的FlashMLA是一款为Hopper GPU设计的高效多头潜在注意力解码内核。它支持BF16计算、采用分页KV缓存技术(块大小64),并在H800 GPU上实现了3000 GB/s内存带宽和580 TFLOPS计算性能。该项目主要优化变长序列推理,可显著降低显存占用和计算开销。FlashMLA的主要应用场景包括大语言模型推理、机器翻译、语音识别和推荐系统等领域。它能加速Transformer计算,提高推理吞吐量,优化长文本处理,降低延迟。该项目受到FlashAttention 2&3和CUTLASS的启发,是2025年AI计算优化领域的重要突破。项目已开源,开发者可通过简单的Python安装命令快速部署使用。这一技术创新将为依赖GPU计算的企业和开发者带来显著的性能提升,推动AI计算效率迈向新的高度。

